
Créer un agent IA avec n8n, c’est brancher un nœud AI Agent sur un modèle de langage, des outils et des consignes. Dans ce guide, on en construit un qui répond à partir de tes propres documents, pour quelques dixièmes de centime par question.
Tout le monde parle d’agents IA. Les démos sur LinkedIn montrent des assistants qui gèrent une entreprise entière pendant que leur créateur sirote un café. Toi, tu veux surtout savoir si c’est utile chez toi, combien ça coûte, et si tu vas t’y perdre entre le RAG, les embeddings et les tokens.
Bonne nouvelle : créer un agent IA avec n8n ne demande pas une ligne de code. Ce qui suit n’est pas une démo théorique. C’est l’agent que j’ai construit sur mes propres supports de formation : un assistant qui lit les PDF rangés dans Google Drive et répond aux questions à partir de ce qu’ils contiennent. Tu as la vidéo, les captures de chaque étape, le workflow à télécharger et le vrai coût relevé sur mon compte OpenAI.
Si tu cherches d’abord des idées d’automatisation plus simples, commence par ces exemples de workflows n8n pour une PME. Ici, on passe à l’étage au-dessus.
Agent IA ou workflow n8n classique : lequel il te faut vraiment
Si ta tâche suit toujours les mêmes étapes, un workflow classique suffit, et il sera moins cher et plus fiable. L’agent IA devient utile quand l’entrée est libre (une question écrite par un humain) et qu’il faut choisir quoi faire pour y répondre.
La différence tient en un mot : la décision. Dans un workflow, c’est toi qui décides à l’avance : « quand une facture arrive, la classer dans tel dossier ». Dans un agent, c’est le modèle de langage qui décide à chaque fois : faut-il consulter les documents, appeler un outil, ou répondre directement. Cette souplesse a un prix. L’agent coûte quelques fractions de centime par passage, et il peut se tromper.
| Critère | Workflow n8n classique | Agent IA n8n |
|---|---|---|
| Qui décide | Toi, une fois pour toutes | Le modèle, à chaque demande |
| Entrée typique | Une donnée structurée (formulaire, ligne, facture) | Une phrase libre écrite par un humain |
| Coût par exécution | Quasi nul | Quelques dixièmes de centime |
| Prévisibilité | Totale | Bonne si on l’encadre, jamais parfaite |
| Cas type | Relancer un impayé, copier un lead dans le CRM | Répondre à une question à partir de documents |
Mon conseil : ne mets pas un agent là où un filtre et une condition suffisent. Automatiser le chaos, ça amplifie juste le chaos. Un agent posé sur un process flou produira des réponses floues, avec beaucoup d’assurance.
L’agent IA n8n qu’on construit : il connaît tous tes documents
On construit un agent qui répond aux questions à partir de tes PDF stockés dans Google Drive. Tu lui écris dans un chat, il va chercher les passages utiles dans tes documents et formule une réponse à partir d’eux.
Dans mon cas, ce sont mes cours et supports de formation. Chez toi, ce sera peut-être tes procédures internes, tes conditions générales, tes fiches produits ou la FAQ que ton équipe répète au téléphone. Le principe ne change pas.
Cette technique porte un nom : le RAG (Retrieval-Augmented Generation). Dit simplement, l’IA ne répond pas de mémoire. Elle cherche d’abord dans une base de connaissances, puis rédige sa réponse avec ce qu’elle a trouvé. C’est ce qui l’empêche de raconter n’importe quoi sur ton entreprise.
Le workflow se découpe en deux flux bien séparés :
- Le chargement : n8n récupère tes PDF, les découpe et les range dans la base de connaissances. Tu le lances à la main, une fois, puis à chaque fois que tes documents changent.
- La conversation : un chat reçoit la question, l’agent consulte la base et répond.
Si tu préfères voir la construction plutôt que la lire, je l’ai filmée en entier :
Ce qu’il te faut avant de commencer
Pour créer un agent IA avec n8n, il te faut quatre choses et aucune compétence en code : une instance n8n, une clé API OpenAI, un compte Google Drive et un dossier de PDF.
- Une instance n8n, en cloud ou auto-hébergée. Si l’outil est nouveau pour toi, lis d’abord ce qu’est n8n et comment il fonctionne. Pour choisir, regarde ce que coûte chaque option dans notre article sur les prix et la version gratuite de n8n. Si tu veux ton propre serveur, le guide pour installer n8n avec Coolify et Hostinger te prend par la main.
- Une clé API OpenAI, créée sur platform.openai.com. Mets une limite de dépense mensuelle dès le départ (j’ai la mienne à 20 dollars, tu la verras plus bas).
- Un compte Google Drive connecté à n8n via ses identifiants Google.
- Un dossier de PDF qui contient vraiment les réponses. Un agent ne sera jamais meilleur que les documents qu’on lui donne.
Étape 1 : charger tes documents dans la base de connaissances
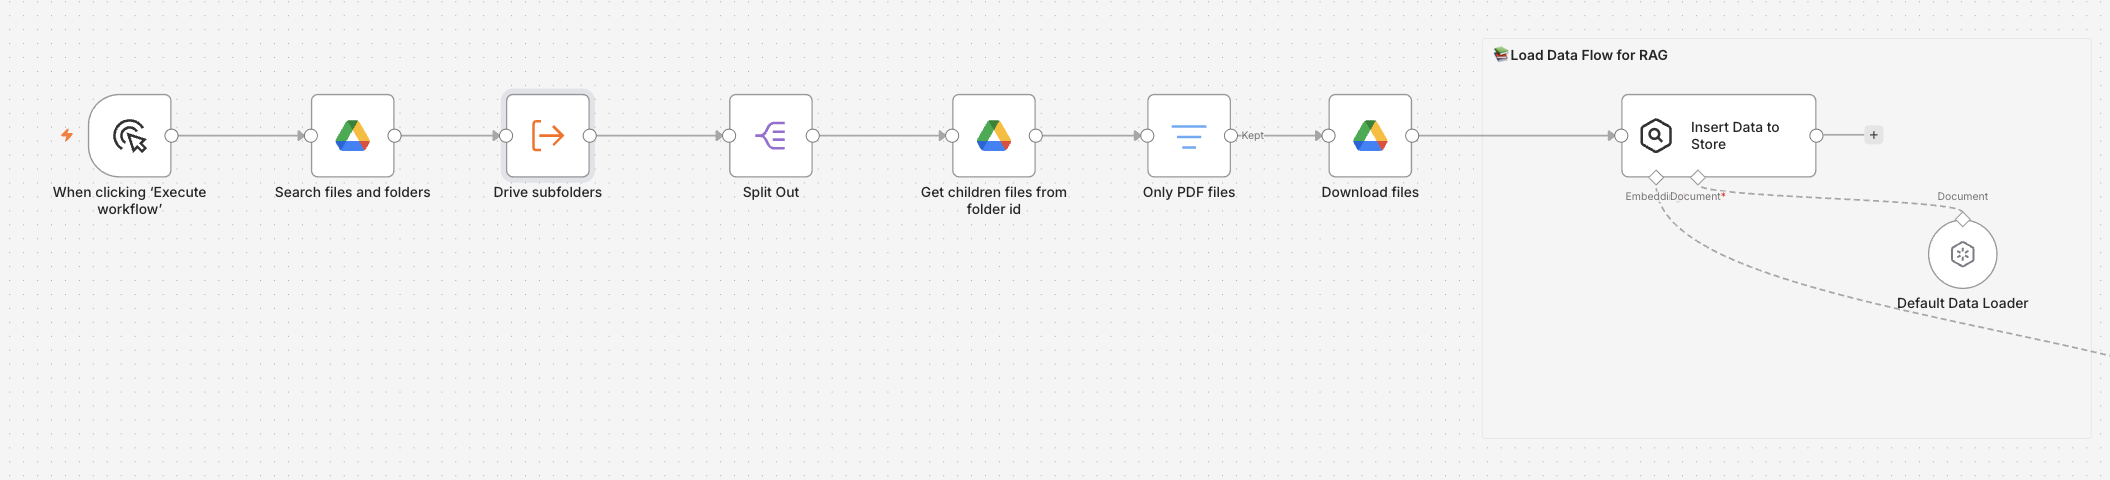
Le premier flux lit tes PDF dans Google Drive, transforme leur texte en embeddings et les range dans un vector store. C’est la bibliothèque dans laquelle l’agent ira piocher.
Récupérer les PDF depuis Google Drive
Un déclencheur manuel (When clicking ‘Execute workflow’) lance le flux. Ensuite, un nœud Google Drive liste les fichiers d’un dossier, et un second les télécharge un par un.
Sur ma capture, il y a quelques nœuds de plus (Drive subfolders, Split Out). Ils servent à fouiller tous les sous-dossiers de mon dossier de formations, grâce à un sous-workflow qui s’appelle lui-même. Pour démarrer, tu n’en as pas besoin : un seul dossier, une seule recherche, ça suffit. La version qui parcourt tous les sous-dossiers est incluse dans le téléchargement en fin d’article.
Ne garder que les PDF
Un nœud Filter laisse passer uniquement les fichiers dont le nom contient « .pdf ». Sans lui, n8n essaierait d’avaler tes tableurs, tes images et tes raccourcis, et le chargement planterait au premier fichier exotique.
Transformer le texte en embeddings
Le nœud Insert Data to Store fait le travail de fond, avec deux sous-nœuds :
- Default Data Loader lit le PDF reçu (en mode binaire) et le découpe en morceaux.
- Embeddings OpenAI transforme chaque morceau en embedding, c’est-à-dire une suite de nombres qui représente son sens.
Imagine une carte. Chaque passage de tes documents y reçoit des coordonnées, et les passages qui parlent de la même chose se retrouvent voisins. Quand une question arrive, on la place sur la même carte et on récupère les passages les plus proches. C’est tout le principe du RAG.
Le stockage se fait ici dans un Simple Vector Store, la base intégrée à n8n, sous la clé cours_formations. Retiens bien ce nom : l’agent devra utiliser exactement le même pour retrouver les documents.
Étape 2 : créer l’agent IA avec n8n, nœud par nœud
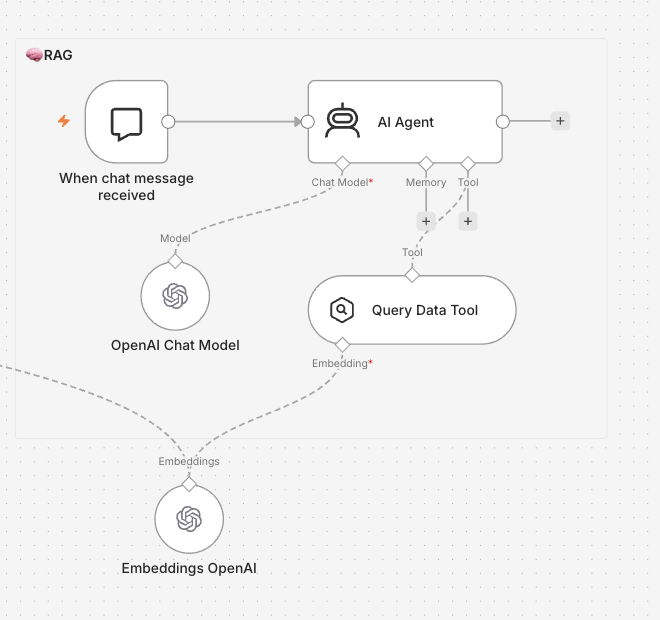
Le second flux tient en quatre éléments : un déclencheur Chat, le nœud AI Agent, un modèle OpenAI et un outil qui interroge la base de connaissances. C’est ici que tu vas vraiment créer ton agent IA avec n8n.
Le déclencheur Chat
Le nœud When chat message received ouvre une fenêtre de discussion. Tu peux la tester directement dans l’éditeur, ou cocher l’option publique pour obtenir une URL à partager à ton équipe. J’ai aussi personnalisé le titre, le message d’accueil et les couleurs, mais ce n’est pas obligatoire pour que ça marche.
Le nœud AI Agent et son modèle
Le nœud AI Agent est le chef d’orchestre. Il reçoit la question du chat, la confie au modèle de langage et décide s’il faut utiliser un outil. Il a trois prises en dessous : Chat Model (obligatoire), Memory et Tool.
Sur Chat Model, j’ai branché OpenAI Chat Model avec gpt-4.1-mini. Un modèle « mini » suffit, parce que le travail est simple : reformuler des passages déjà trouvés. Pas besoin du modèle le plus cher pour ça, et la différence de prix se sent dès quelques centaines de questions.
Brancher la base de connaissances comme outil de l’agent
Sur la prise Tool, on branche un second nœud Simple Vector Store, cette fois en mode retrieve-as-tool. Il s’appelle ici Query Data Tool. Trois réglages comptent :
- Le nom de l’outil :
knowledge_base. - La description : « Use this knowledge base to answer questions from the user ». C’est elle que le modèle lit pour savoir quand s’en servir. Une description floue donne un agent qui oublie d’aller chercher.
- La clé :
cours_formations, la même qu’au chargement.
L’outil a besoin des mêmes Embeddings OpenAI que le flux de chargement, pour placer la question sur la même « carte » que les documents. Sur le canevas, un seul nœud Embeddings alimente les deux.
Ce détail fait toute la différence entre un agent et un chatbot. Ce n’est pas le workflow qui interroge la base à chaque fois. C’est l’agent qui décide d’aller chercher. Demain, tu pourras lui ajouter un deuxième outil (un agenda, un CRM, un formulaire de ticket) sans rien démonter.
Le prompt système qui l’empêche d’inventer
Dans les options du nœud AI Agent, ajoute un System Message. C’est la consigne permanente de l’agent, celle qui s’applique à toutes les conversations. Voici la mienne :
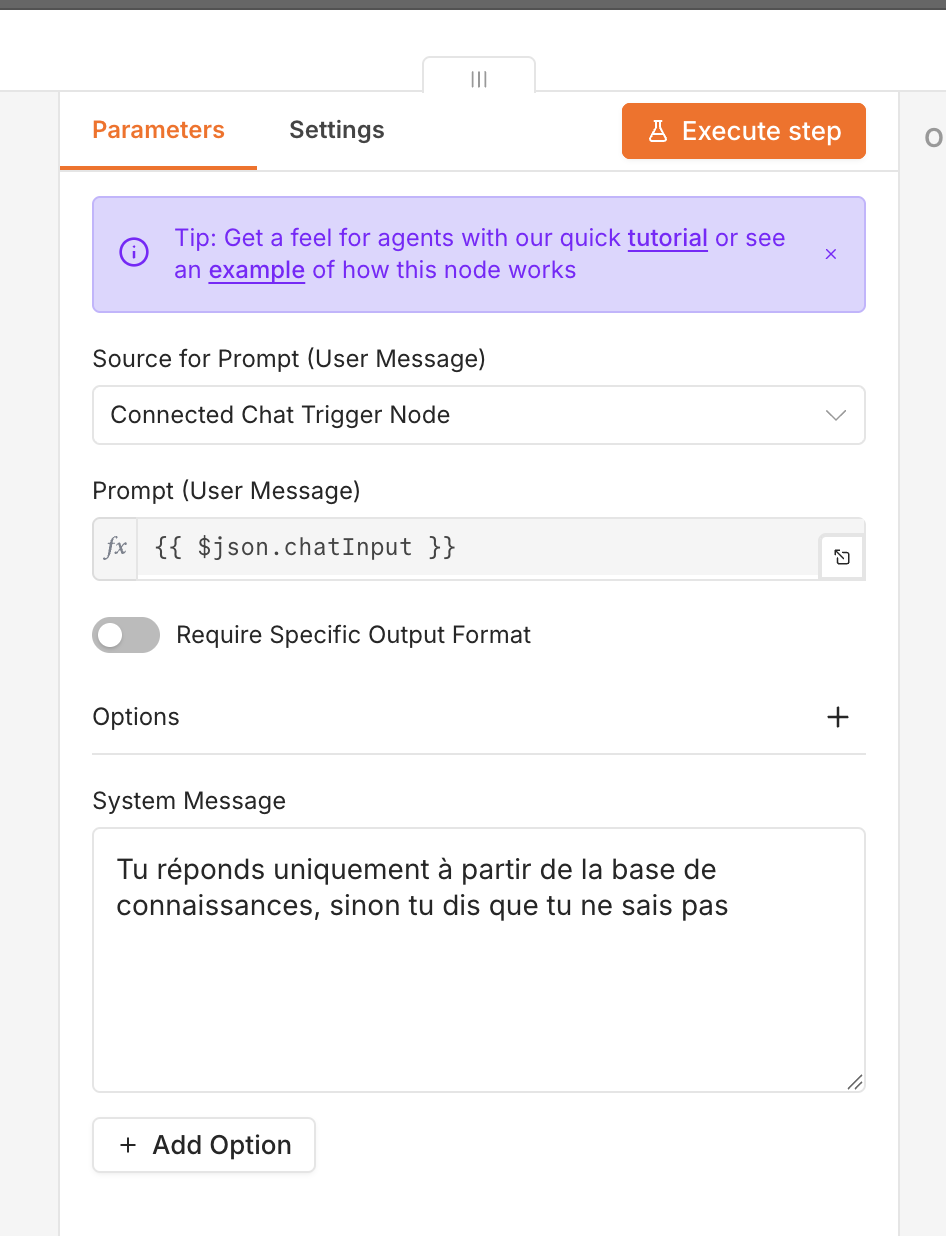
Une phrase, et elle change tout : « Tu réponds uniquement à partir de la base de connaissances, sinon tu dis que tu ne sais pas. » Sans elle, le modèle complète les trous avec ses connaissances générales. Pour une question sur tes tarifs ou tes délais de livraison, c’est exactement ce que tu ne veux pas.
Étape 3 : tester ton agent IA n8n dans le chat
Lance d’abord le flux de chargement, puis ouvre le chat (bouton Open chat en bas de l’éditeur) et pose une question dont la réponse se trouve dans tes PDF.
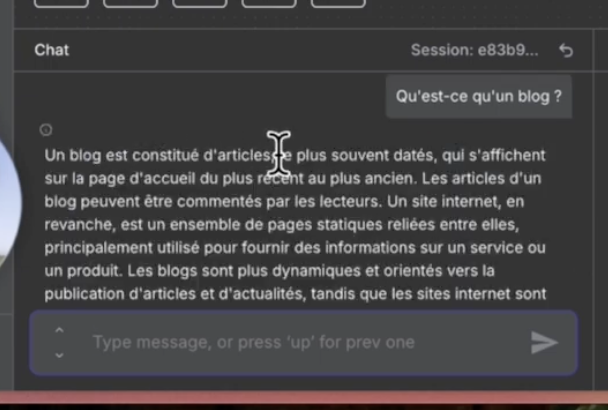
Ici, je lui demande ce qu’est un blog, une notion couverte dans un de mes supports. La réponse reprend les termes du support (articles datés, comparaison avec un site internet classique), pas une définition piochée au hasard.
Fais ensuite le test qui compte vraiment : pose une question hors sujet, par exemple la capitale du Pérou. Si ton prompt système tient, l’agent doit répondre qu’il ne sait pas. S’il répond « Lima », durcis la consigne avant de laisser quiconque s’en servir.
Dernier réflexe : ouvre l’onglet Executions et clique sur une conversation. Tu y vois si l’agent a bien appelé l’outil knowledge_base ou s’il a répondu sans chercher. C’est le meilleur outil de débogage que tu auras.
La mémoire : pourquoi cet agent n’en a pas (et quand l’ajouter)
Mon agent n’a pas de mémoire, et c’est voulu : pour répondre à des questions sur des documents, chaque question se suffit à elle-même. Sur le canevas, la prise Memory du nœud AI Agent est vide.
Sans mémoire, l’agent ne se souvient pas du message précédent. Si tu lui demandes « parle-moi du module 2 », puis « et combien de temps il dure ? », il ne saura pas de quoi tu parles. Pour une base de questions-réponses, c’est un défaut acceptable, et même un avantage. Chaque appel envoie moins de texte au modèle, donc coûte moins cher, et l’agent ne dérive pas sur une conversation de vingt messages.
Le jour où tu veux une vraie conversation, l’ajout prend trente secondes. Clique sur le « + » sous Memory et choisis Simple Memory. Le nœud garde les derniers échanges de chaque session (5 par défaut) et les renvoie au modèle à chaque nouveau message. Garde la fenêtre courte : chaque message gardé en mémoire est repayé à chaque question.
Combien coûte un agent IA n8n : les chiffres de mon compte OpenAI
Compte environ un tiers de centime par question avec gpt-4.1-mini, soit quelques euros par mois pour un usage de PME. Voici d’où sort ce chiffre.
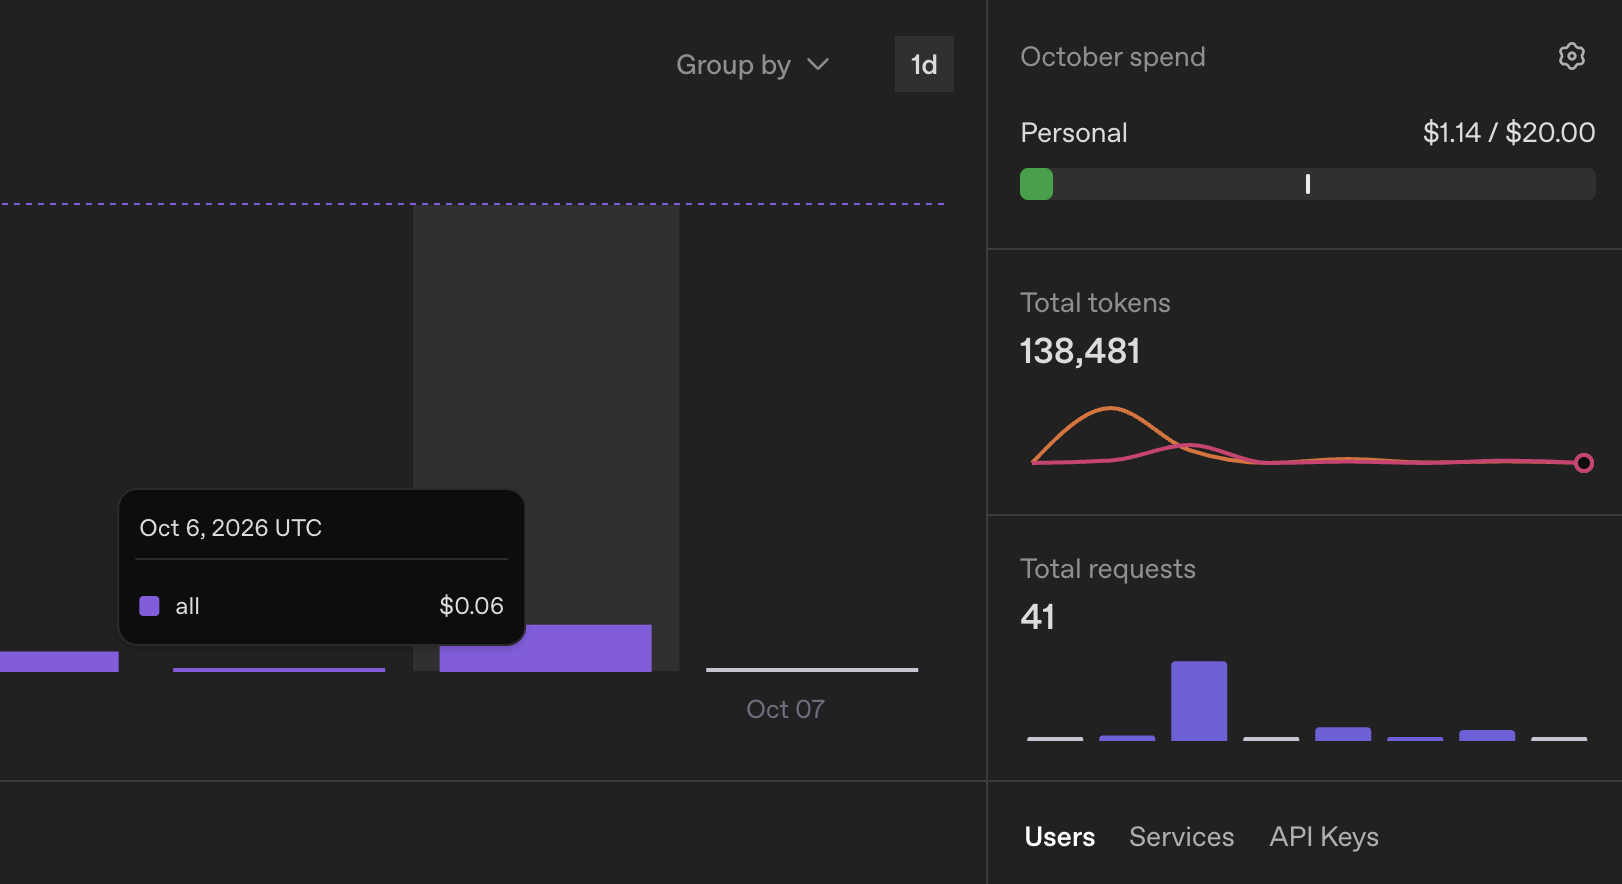
Sur la semaine de tests, mon compte affiche 41 requêtes et 138 481 jetons (tokens). Le jeton est l’unité de facturation : environ trois quarts de mot en anglais, un peu moins en français. Ça fait en moyenne 3 400 jetons par requête, en grande majorité en entrée, parce que l’agent envoie au modèle les passages trouvés dans les PDF.
Au tarif public de gpt-4.1-mini (0,40 dollar le million de jetons en entrée, 1,60 dollar en sortie), cette semaine représente environ 6 à 8 centimes. Le graphique confirme l’ordre de grandeur : 0,06 dollar le jour où j’ai le plus testé.
Le coût d’un agent IA n8n par question et par mois
Une question coûte en général deux appels au modèle. Le premier sert à décider d’utiliser l’outil, le second à rédiger la réponse avec les passages trouvés. On arrive à environ 0,35 centime de dollar par question :
| Questions par mois | Coût OpenAI estimé | Exemple d’usage |
|---|---|---|
| 100 | environ 0,35 $ | Une petite équipe qui teste |
| 1 000 | environ 3,50 $ | Un assistant interne utilisé tous les jours |
| 10 000 | environ 35 $ | Un chat ouvert aux clients sur ton site |
Le chargement des documents ne pèse presque rien. Les embeddings utilisent par défaut text-embedding-3-small, facturé 0,02 dollar le million de jetons : quelques centaines de pages de PDF coûtent moins d’un centime à indexer.
Soyons honnêtes sur la méthode. C’est une estimation tirée de mes tests réels, pas une mesure question par question. Le coût grimpe si tes documents sont longs, si tu ajoutes une mémoire ou si tu passes à un modèle plus gros. À ces montants s’ajoute l’hébergement de n8n, sauf si tu utilises déjà une instance. Ce qui ne change pas : pour une PME, la facture IA d’un agent bien cadré se compte en euros, pas en centaines d’euros.
Avant de mettre ton agent IA n8n en production
Ce que tu viens de créer, un agent IA avec n8n et une base en mémoire, suffit pour tester et pour un usage interne. Avant de l’ouvrir à des clients, trois points sont à régler : la base qui disparaît, les garde-fous et l’hébergement des données.
La base en mémoire disparaît au redémarrage
Le Simple Vector Store garde tout dans la mémoire vive de n8n. Au premier redémarrage du serveur ou à la première mise à jour, la base est vide et l’agent ne sait plus rien, jusqu’à ce que tu relances le chargement. La documentation de n8n le réserve d’ailleurs au développement, et sur n8n Cloud les données sont purgées au bout de 7 jours. En production, remplace-le par une base persistante comme Qdrant, Supabase ou PGVector : les nœuds existent dans n8n et se branchent exactement au même endroit.
Les garde-fous d’un agent qui agit
Un agent qui répond à des questions risque peu. Un agent qui agit (envoie un email, écrit dans ton CRM, crée un devis) peut faire des dégâts. Trois règles simples :
- Un prompt strict, comme celui vu plus haut, qui dit ce que l’agent fait et ce qu’il refuse.
- Le moins d’outils possible. Chaque outil ajouté est une occasion de plus de se tromper d’outil.
- Une validation humaine avant toute action irréversible. n8n sait mettre un workflow en pause en attendant ton accord, par email ou sur Slack.
Mistral pour rester RGPD
Avec OpenAI, les questions de tes utilisateurs et les extraits de tes documents partent vers un prestataire américain. Pour des données sensibles, n8n propose des nœuds Mistral Cloud Chat Model et Embeddings Mistral Cloud, qui se branchent sur les mêmes prises. Mistral est une entreprise française. Attention, ma démo tourne sur OpenAI : si tu changes de modèle, refais le chargement avec les nouveaux embeddings, car les deux « cartes » ne sont pas compatibles.
Récupère le workflow complet de l’agent
Le workflow de cet agent, avec la version qui parcourt tous les sous-dossiers de ton Google Drive, est dans la formation offerte. Tu l’importes dans n8n, tu branches tes identifiants et tu as ta propre base de connaissances en moins d’une heure.
FAQ : créer un agent IA avec n8n
Faut-il savoir coder pour créer un agent IA avec n8n ?
Non. Tout se fait avec des nœuds à glisser et à relier : déclencheur, AI Agent, modèle, outils. Il faut seulement savoir créer une clé API et connecter un compte Google. Le code n’intervient que pour des besoins très particuliers.
Combien coûte un agent IA n8n par mois ?
Avec gpt-4.1-mini, compte environ 0,35 centime de dollar par question, soit 3,50 dollars pour 1 000 questions. Ajoute l’hébergement de n8n : gratuit si tu as déjà une instance, quelques euros par mois sur un petit serveur.
Quelle différence entre un agent IA et un workflow n8n classique ?
Un workflow suit des étapes fixées à l’avance. Un agent IA reçoit une demande libre et décide lui-même quoi faire, par exemple consulter tes documents ou utiliser un outil. Il est plus souple, mais plus cher et moins prévisible.
Peut-on utiliser Mistral à la place d’OpenAI ?
Oui. n8n propose des nœuds Mistral Cloud pour le modèle de chat et pour les embeddings. Ils se branchent sur les mêmes prises que les nœuds OpenAI. Pense à recharger tes documents avec les embeddings Mistral.
La version gratuite de n8n suffit-elle pour un agent IA ?
Oui. La version Community auto-hébergée inclut le nœud AI Agent, les vector stores et le déclencheur Chat, sans limite d’exécutions. Tu paies uniquement ton serveur et les appels au modèle.
Ton premier agent, cette semaine
Tout s’apprend, mais rien ne remplace l’itération. La formation offerte t’apprend à créer un agent IA avec n8n et tes premiers workflows de bout en bout, à partir de cas réels d’entreprise.
Accéder à la formation offerte sur l’automatisation avec n8n
Un agent IA n’a rien d’un collègue génial. C’est un stagiaire très rapide, qui ne sait que ce que tu lui as donné à lire. Range bien tes documents, et c’est lui qui fera bonne impression à ta place.
0 commentaires